video-use: sửa video bằng Claude Code, TechVision học được gì
video-use là một kho mã nguồn mở của nhóm Browser Use: thả cảnh quay thô vào một thư mục, trò chuyện với Claude Code, nhận lại file final.mp4. TechVision không cài công cụ này. Đội video chỉ mượn hai ý trong đó cho bộ dựng riêng của mình, rồi đo lại trên ba video thật. Bài này kể đúng hai ý đó, con số đo được, và những thứ cố ý không lấy.
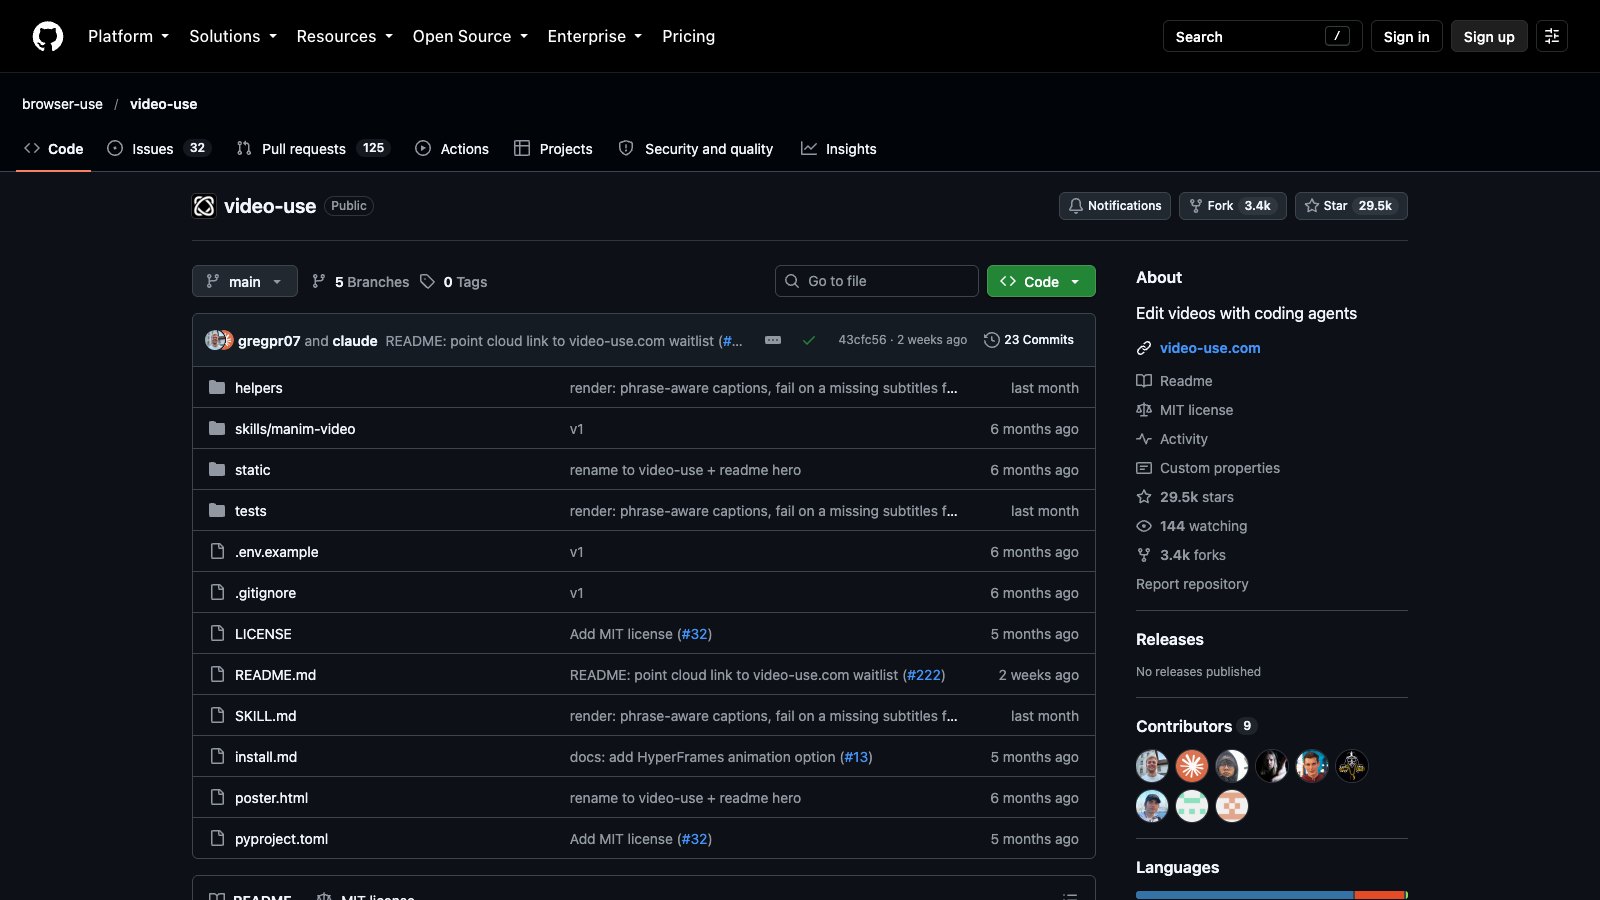
Trang kho browser-use/video-use trên GitHub lúc TechVision mở ra đọc, rạng sáng 22/10/2026: 29,5 nghìn sao, 3,4 nghìn fork, giấy phép MIT. Ảnh: TechVision chụp màn hình github.com
video-use là kho mã nguồn mở của nhóm Browser Use, giấy phép MIT, giúp Claude Code (và các agent có quyền chạy lệnh) dựng video từ cảnh quay thô; đọc ngày 22/10/2026 kho có 29.477 sao. Công cụ không bắt mô hình xem video mà cho nó đọc bản chép lời có mốc thời gian từng chữ, chỉ xem ảnh ghép khung hình + sóng âm khi cần quyết định. TechVision không cài video-use, chỉ mượn hai ý cho bộ dựng HTML + ffmpeg của mình: fade 30 ms ở mọi chỗ nối câu để hết tiếng bụp, và tờ soát 4 khung hình + sóng âm tại mỗi điểm bị gắn cờ. Lần chạy thử trên video ChatGPT 14 phút 21 giây soát 274 điểm chuyển cảnh, 192 chỗ nối câu trong 17 giây, ra 8 tiếng bụp nhẹ; video Apple dựng sau khi có fade ra 0 cờ trên 101 chỗ nối.
Đội video của TechVision dựng mọi video bằng một bộ công cụ tự viết: mỗi cảnh là một trang HTML + JavaScript, Chrome headless chụp lại từng khung hình, ffmpeg ghép hình với giọng đọc thành file MP4. Cách làm này cho phép sửa một con số trên màn hình bằng một dòng mã, nhưng cũng sinh ra những lỗi mà mắt người dễ bỏ sót khi xem lại một video dài 14 phút: một tiếng bụp nhỏ ở chỗ hai câu nối nhau, hay một cảnh trắng chỉ lóe lên trong nửa giây.
Tháng 10/2026, khi tìm cách soát những lỗi đó, đội đọc kho mã nguồn mở video-use của nhóm Browser Use trên GitHub. Bài này giải thích video-use là gì theo đúng tài liệu của nó, rồi kể lại hai ý TechVision mượn về, con số đo được trên ba video thật, và những thứ cố ý không lấy. Mọi thông tin về video-use đọc trực tiếp từ README và SKILL.md của kho vào ngày 22/10/2026; mọi con số về video của TechVision là số đo nội bộ của đội.
| Kho mã | github.com/browser-use/video-use, mô tả "Edit videos with coding agents" |
| Nhóm phát triển | Browser Use, cũng là nhóm làm thư viện browser-use cho AI điều khiển trình duyệt |
| Giấy phép | MIT, mã nguồn mở hoàn toàn |
| Ngôn ngữ | Python khoảng 80,8%, HTML 18,4%, Shell 0,8% |
| Độ phổ biến | 29.477 sao, 3.426 fork, 9 người đóng góp, 23 commit trên nhánh main |
| Ngày tạo kho | 12/04/2026; lần đẩy mã gần nhất 08/10/2026 (giờ UTC) |
| Cần để chạy | Claude Code, Codex hoặc agent có quyền chạy lệnh; ffmpeg; API key ElevenLabs để chép lời |
video-use là gì và làm việc ra sao
Theo README, video-use là công cụ “edit videos with Claude Code”. Người dùng thả các đoạn quay thô vào một thư mục, mở Claude Code (hoặc Codex, Hermes, Openclaw, bất kỳ agent nào có quyền chạy lệnh shell) ngay trong thư mục đó, gõ một câu kiểu “edit these into a launch video”, và nhận về file edit/final.mp4 nằm cạnh cảnh quay gốc. README liệt kê loại nội dung nó hướng tới: người nói trước máy quay, video ghép nhanh, hướng dẫn, du lịch, phỏng vấn, không có mẫu dựng sẵn hay menu.
Danh sách việc công cụ làm, theo README: cắt bỏ tiếng ậm ừ (umm, uh), câu nói hỏng và khoảng lặng giữa các lần quay; tự chỉnh màu từng đoạn; fade âm thanh 30 ms ở mọi điểm cắt để không nghe tiếng bụp; đốt phụ đề vào hình (mặc định cụm 2 chữ in hoa); sinh lớp hoạt họa bằng HyperFrames, Remotion, Manim hoặc PIL qua nhiều agent con chạy song song; tự soát bản đã render tại mọi điểm cắt trước khi cho người dùng xem; và ghi nhớ phiên làm việc vào file project.md.
Ý cốt lõi nằm ở câu “The LLM never watches the video. It reads it”. Mô hình không xem video mà đọc nó qua hai lớp. Lớp một là bản chép lời: mỗi file nguồn được gửi một lần qua dịch vụ Scribe của ElevenLabs, trả về mốc thời gian từng chữ, phân biệt người nói và các sự kiện âm thanh như tiếng cười, tiếng vỗ tay. Tất cả gói lại thành một file văn bản khoảng 12 KB tên takes_packed.md. Lớp hai là ảnh ghép khung hình + sóng âm do script timeline_view vẽ ra, chỉ gọi khi cần quyết định, ví dụ một khoảng lặng mơ hồ hay so hai lần quay.
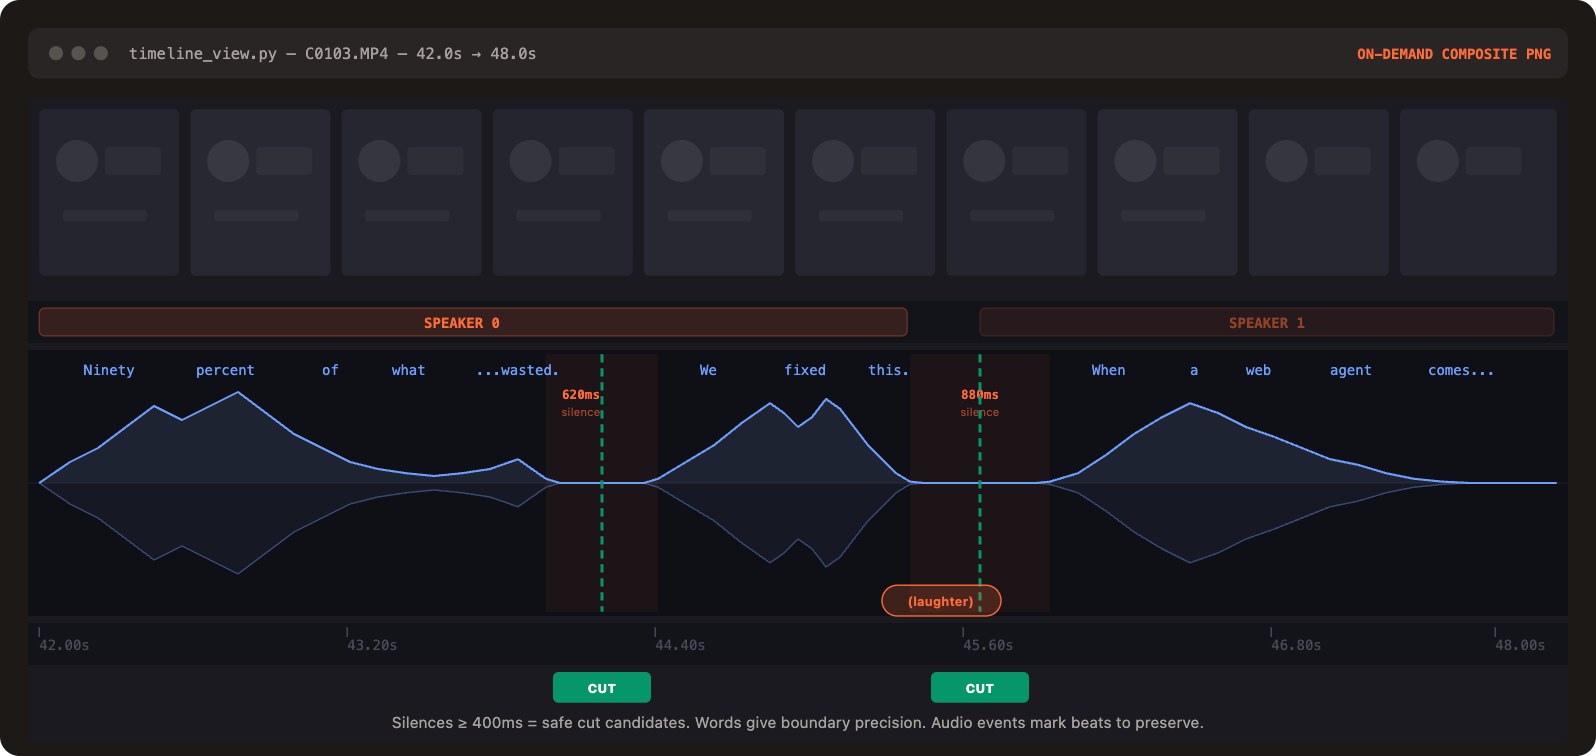
README so sánh chi phí: nếu đưa thẳng 30.000 khung hình cho mô hình, mỗi khung khoảng 1.500 token, sẽ tốn chừng 45 triệu token; video-use chỉ cần 12 KB chữ và vài tấm ảnh. Nhóm phát triển ví cách làm này giống thư viện browser-use đưa cho AI cấu trúc DOM của trang web thay vì ảnh chụp màn hình.
Quy trình gồm sáu bước nối tiếp: chép lời, đóng gói, mô hình suy luận, xuất danh sách điểm cắt (EDL), render, rồi tự soát. Nếu bước soát thấy lỗi thì sửa và render lại, tối đa 3 vòng. File SKILL.md còn ghi 12 “quy tắc cứng” mà tác giả coi là chuyện đúng sai chứ không phải gu thẩm mỹ, chẳng hạn phụ đề luôn đặt cuối chuỗi bộ lọc để không bị lớp hoạt họa che, không bao giờ cắt giữa một chữ, và phải được người dùng duyệt kế hoạch bằng lời trước khi đụng vào bản dựng.
Vì sao TechVision không cài video-use
Câu trả lời ngắn: hai công cụ giải hai bài toán khác nhau. video-use sinh ra để cắt cảnh quay thật, nơi việc khó là chọn lần quay tốt nhất và cắt đúng ranh giới chữ trong lời nói tự nhiên. Video của TechVision không có cảnh quay người. Kịch bản viết trước, giọng đọc là giọng tổng hợp, từng câu một, và hình là các trang HTML vẽ theo mốc thời gian của chính các câu đó. Không có tiếng ậm ừ nào để cắt, không có lần quay nào để so.
Thêm nữa, video-use cần API key ElevenLabs để chép lời, tức thêm một dịch vụ bên ngoài và chi phí theo gói tài khoản ElevenLabs. Bộ dựng của TechVision đã biết chính xác mỗi câu bắt đầu và kết thúc ở giây nào vì nó tự đặt mốc khi ghép giọng, nên không cần chép lời lại. Vì vậy đội không cài, không chạy video-use, và không viết lại công cụ đó. Thứ hữu ích nằm ở hai ý nhỏ trong cách nó kiểm soát chất lượng, áp được vào bất kỳ dây chuyền nào có ffmpeg.
Ý thứ nhất: fade 30 ms ở mỗi chỗ nối câu
Quy tắc cứng số 3 của video-use ghi: fade âm thanh 30 ms ở mọi ranh giới đoạn, nếu không sẽ nghe tiếng bụp ở mọi điểm cắt. Lý do kỹ thuật đơn giản. Khi ghép hai đoạn âm thanh sát nhau, mẫu cuối của đoạn trước và mẫu đầu của đoạn sau có thể ở hai mức rất khác nhau. Dạng sóng nhảy thẳng đứng tại điểm nối, và tai người nghe ra một tiếng tách nhỏ, đội gọi là “tiếng bụp”.
Trước đó, bộ dựng của TechVision chỉ cắt khoảng lặng đầu và cuối mỗi câu giọng đọc bằng bộ lọc silenceremove rồi nối các câu lại. Từ bản cập nhật tháng 10/2026, chuỗi bộ lọc ghép giọng thêm afade=t=in:d=0.03 sau bước cắt lặng, đảo ngược đoạn âm thanh bằng areverse, cắt lặng và fade thêm một lần nữa, rồi đảo lại. Kết quả là mỗi câu tự tăng dần âm lượng trong 30 ms đầu và giảm dần trong 30 ms cuối. Phép đảo hai lần là mẹo để dùng cùng một bộ lọc cho cả hai đầu mà không cần biết trước độ dài câu.
Không có phép màu nào ở đây, và 30 ms cũng không phải con số thần kỳ. Nó đủ ngắn để người nghe không nhận ra âm lượng đang lên xuống, đủ dài để điểm nối không còn nhảy đột ngột. Thay đổi chỉ là một dòng trong script dựng, nhưng nó áp cho mọi video về sau mà không ai phải nhớ.
Ý thứ hai: tờ soát khung hình + sóng âm tại mỗi điểm cắt
Ý thứ hai lấy từ bước tự soát của video-use: sau khi render, chạy timeline_view trên chính bản đã render, tại mọi điểm cắt, để tìm chỗ nhảy hình, nhọn sóng âm hay phụ đề bị che. Ở video-use, người nhìn tờ ảnh đó là mô hình AI. Ở TechVision, đội viết một script mới tên scripts/cut_check.py cho người nhìn, và để máy làm phần lọc trước bằng ngưỡng số.
Script làm việc như sau. Nó giải mã video đúng một lần ở dạng ảnh xám 96x54 điểm ảnh, 10 khung mỗi giây, và giải mã âm thanh một lần ở dạng mono 16 kHz. Mốc chuyển cảnh và mốc đầu cuối của từng câu lấy từ file dữ liệu của chính bản đã render, nên không cần đoán. Sau đó nó tìm hai loại lỗi:
- Cảnh trống hoặc trắng: trong 0,3 giây đầu mỗi cảnh, nếu một khung hình gần như một màu (độ lệch chuẩn độ sáng dưới 2,5) thì gắn cờ TRỐNG, hoặc TRẮNG nếu khung đó gần trắng hẳn.
- Tiếng bụp: tại mỗi chỗ nối câu, đo bước nhảy mẫu lớn nhất trong khoảng ±15 ms. Gắn cờ khi bước nhảy vượt 0,08 và lớn hơn 2,5 lần phân vị 95 của các bước nhảy trong ±0,2 giây xung quanh.
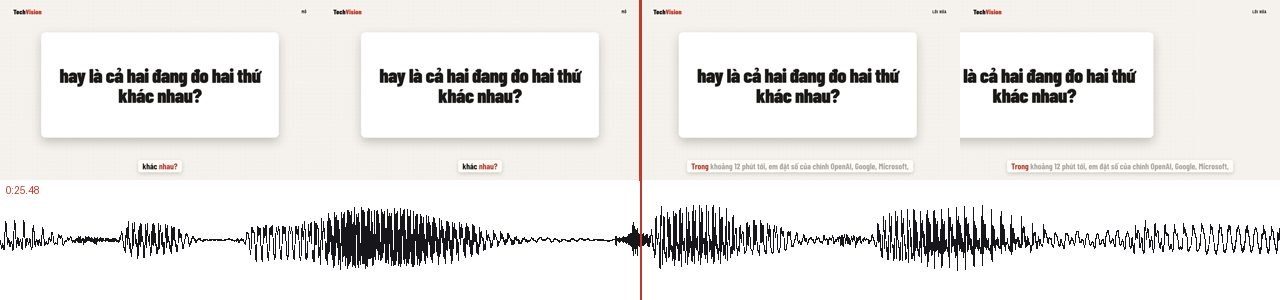
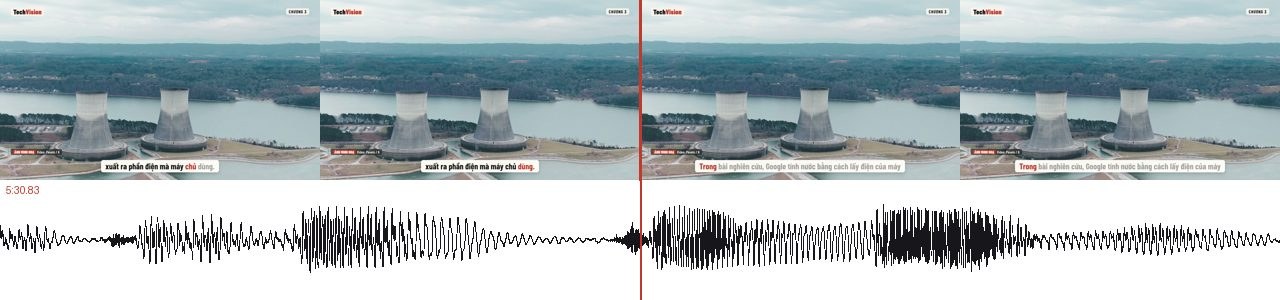
Với mỗi cờ, script vẽ một tờ ảnh: 4 khung hình ở các mốc -0,2 / -0,03 / +0,03 / +0,2 giây quanh điểm cắt, cộng dải sóng âm ±0,5 giây, vạch đỏ đánh dấu điểm cắt. Script thoát với mã lỗi nếu còn bất kỳ cờ nào, và video còn cờ thì không được hẹn lịch đăng.
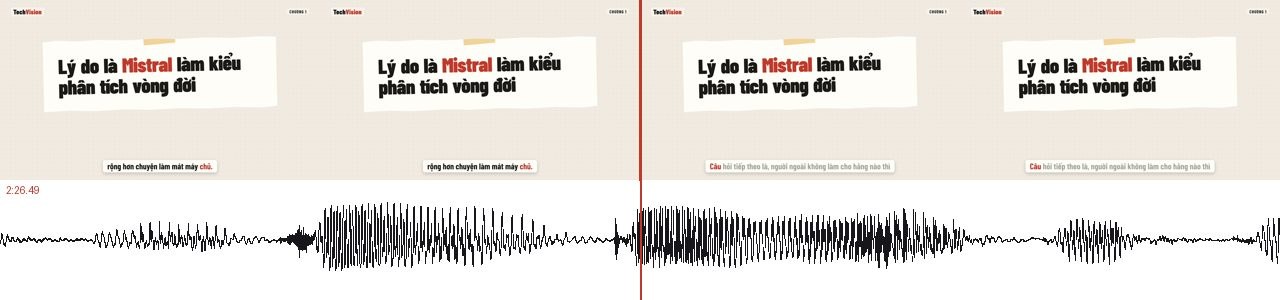
Phần kiểm cảnh trống sinh ra từ một lỗi thật. Ở video về LG, một đường link Wikimedia Commons trỏ tới trang mô tả tệp chứ không phải tệp ảnh. Thứ tải về là một trang HTML nhưng được lưu với đuôi .jpg, trình dựng không vẽ được, và cảnh đó ra trắng. Mắt người xem lại video dài dễ trượt qua một cảnh như vậy, nhưng một phép đo độ lệch chuẩn thì không.
Kết quả đo trên ba video thật
Phép thử đầu tiên là video “ChatGPT tốn bao nhiêu điện, nước?” dài 14 phút 21 giây. Video này được dựng và hẹn lịch đăng trước khi có bước fade lẫn bộ soát, nên nó là một phép thử ngược: chạy công cụ mới trên sản phẩm cũ để xem công cụ có bắt được thứ gì không. Bộ soát chạy hết 274 điểm chuyển cảnh và 192 chỗ nối câu trong 17 giây. Kết quả: 0 khung trống hay trắng, 8 tiếng bụp nhẹ, biên độ nhảy từ 0,28 tới 0,46 trên mức nền 0,09 tới 0,12. Đúng loại lỗi mà fade 30 ms sinh ra để xử lý.
Video ChatGPT điện nước 14 phút 21 giây, video đầu tiên chạy qua bộ soát cut_check: 274 điểm chuyển cảnh, 192 chỗ nối câu, 8 tiếng bụp nhẹ. Nguồn: YouTube TechVision
Nội dung của chính video đó, với bảng nguồn cho từng con số, nằm ở bài ChatGPT tốn bao nhiêu điện, nước: số của OpenAI, Google và Việt Nam. Trong 8 cờ, có cờ nằm đúng chỗ cảnh cũng chuyển, như tờ soát ở giây 5:30.83 dưới đây, nơi một đoạn video nhà máy điện kết thúc và câu tiếp theo bắt đầu.
Phép thử thứ hai là video về sự kiện Apple “Pro and tell” dài 7 phút 16 giây, dựng sau khi đã có fade 30 ms. Bộ soát đi qua 127 điểm chuyển cảnh và 101 chỗ nối câu, ra 0 cờ. Phép thử thứ ba là bản dọc 62,6 giây của cùng video cho Shorts và Reels: 14 điểm chuyển cảnh, 13 chỗ nối câu, cũng 0 cờ. Ai muốn biết video đó nói gì có thể xem trang sự kiện Apple Pro and tell 28/10/2026.
Cần nói rõ giới hạn của các con số này. Hai video sạch cờ cho thấy fade 30 ms làm đúng việc ở dây chuyền này, nhưng đó mới là hai sản phẩm, chưa phải một thống kê lớn. Ngưỡng 0,08 và 2,5 lần là ngưỡng đội tự chọn sau khi xem tờ soát, không phải chuẩn công nghiệp; ngưỡng khác sẽ ra số cờ khác.
Bài học cho người làm video ở Việt Nam
Phần lớn người làm video ở Việt Nam, từ kênh cá nhân tới đội nội dung của doanh nghiệp nhỏ, dựng bằng phần mềm có giao diện như CapCut hay Premiere. Với họ, video-use không phải thứ dùng được ngay: nó cần cài ffmpeg, Python, một agent chạy lệnh như Claude Code và một API key ElevenLabs. Nhưng với những người đã quen AI agent chạy trên máy tính, đây là một mẫu tham khảo hiếm hoi về cách để AI làm việc với video mà không đốt hàng triệu token.
Ở mức tổng quát hơn, có hai điều đáng giữ. Thứ nhất, lỗi kỹ thuật nhỏ như tiếng bụp nên được chặn bằng một quy tắc cố định trong dây chuyền, không trông vào việc người dựng nhớ. Thứ hai, soát chất lượng hiệu quả nhất khi máy lọc trước bằng ngưỡng số và người chỉ nhìn vào những chỗ bị gắn cờ: 8 tờ ảnh cho một video 14 phút đọc hết trong vài phút, còn xem lại toàn bộ thì mất hơn 14 phút và vẫn dễ sót.
Cũng nên nhớ video-use là kho mới, tạo tháng 4/2026, còn 157 mục mở (issue và pull request) khi TechVision đọc. Ai định dùng thật cho công việc nên đọc kỹ install.md, SKILL.md và tự thử trên cảnh quay của mình trước, nhất là với giọng nói tiếng Việt, phần TechVision chưa thử.